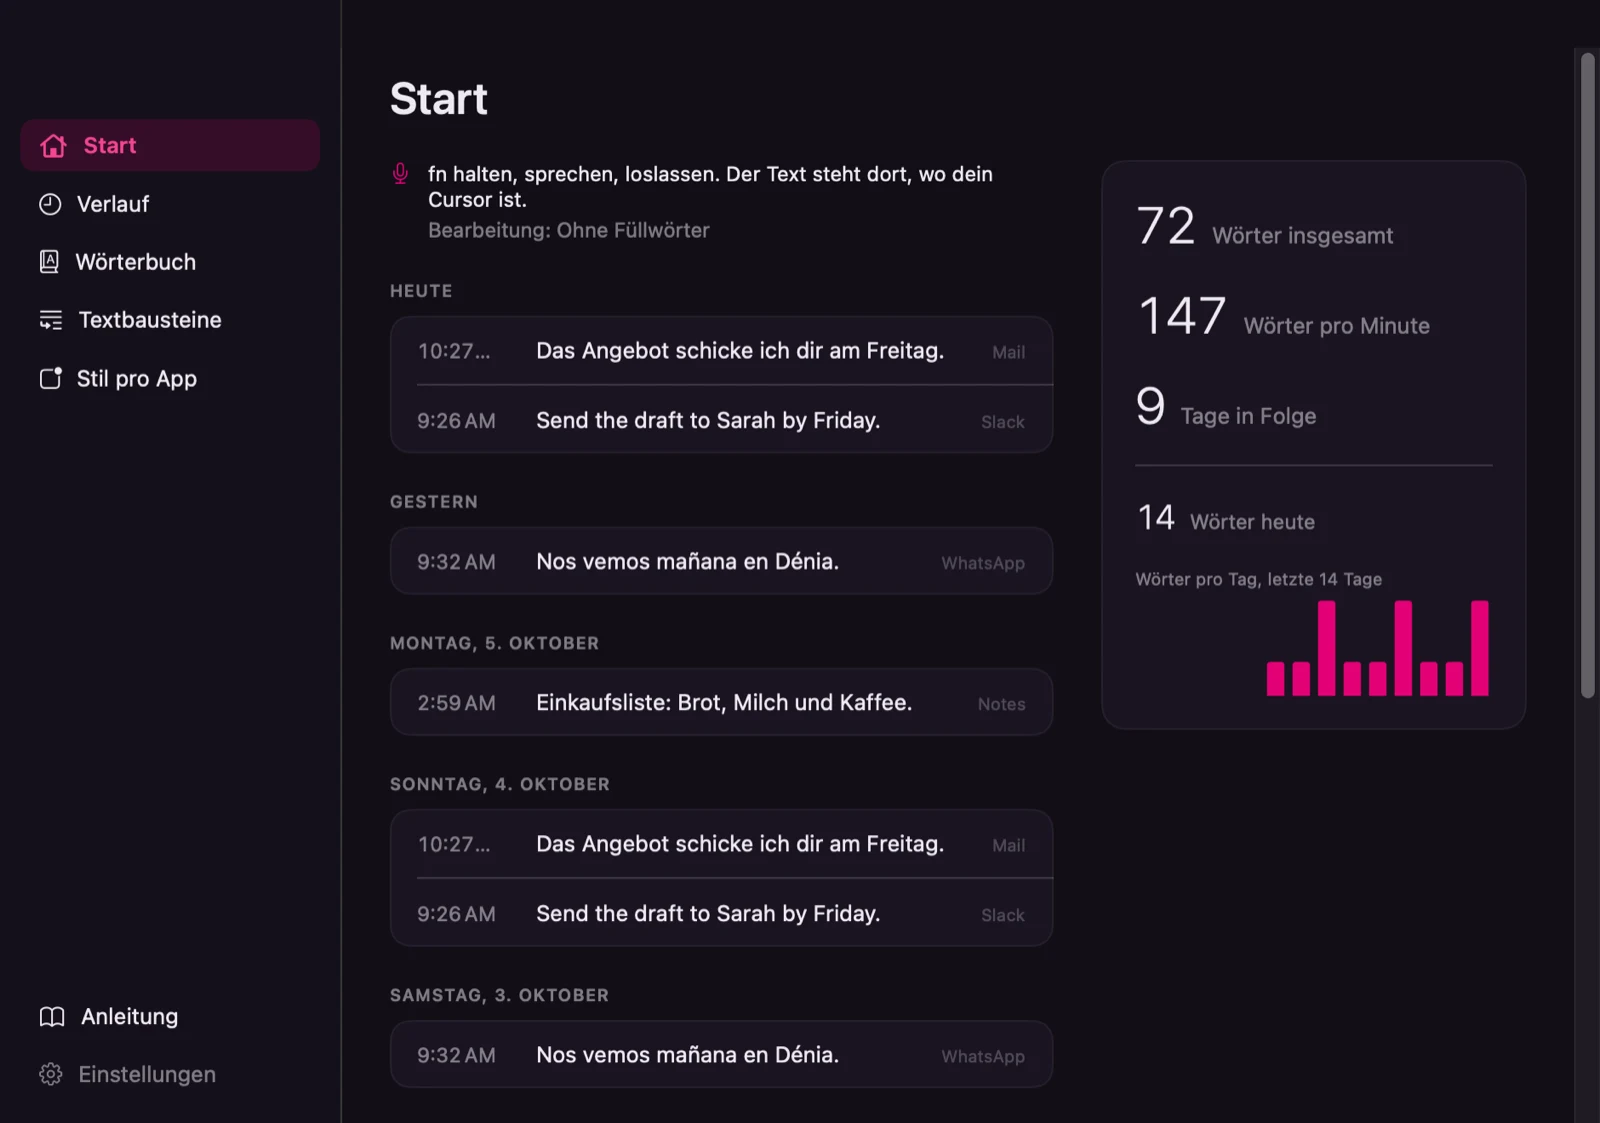
Ich wollte so diktieren, wie ich arbeite: Taste halten, sprechen, loslassen, und der Text steht dort, wo der Cursor ist, auf Deutsch, Spanisch oder Englisch. Ein Werkzeug mit so vielen beweglichen Teilen ist nur dann vertrauenswürdig, wenn man zu jedem Teil sagen kann, warum es da ist. Also habe ich eines für meinen eigenen Mac gebaut und jede Entscheidung aufgeschrieben, als ich sie traf.
Es ist eine kleine Menüleisten-App namens Flabbeo. Sie verkauft nichts, deshalb geht es auf dieser Seite darum, wie entschieden und geprüft wurde.
Zuerst eine Regel
Alles läuft auf dem Mac. Die Spracherkennung ist NVIDIAs Parakeet-Modell, das Aufräumen übernimmt ein kleines Sprachmodell, Qwen3.5-4B, über llama.cpp. Der einzige Netzwerkcode im ganzen Projekt ist ein einmaliger Download dieser beiden Modelle von Hugging Face, auf genaue Versionen festgelegt und gegen Prüfsummen kontrolliert. Es gibt keine Telemetrie und keinen Update-Kanal. Eine Fußnote, weil sie stimmt: Der Text, den es tippt, geht dorthin, wohin die App ihn schickt, in die Sie tippen.
Entscheidungen, und worauf sie sich stützten
Ich habe drei KI-Recherche-Berichte nicht einfach übernommen. Ich habe sie gegen Primärquellen bewertet. Das nützlichste Ergebnis war ein Nebenbefund: ein besseres Projekt, von dem sich lernen ließ.
Übernommener Code braucht eine Lizenzprüfung und eine Kopfzeile. 26 Quelldateien tragen eine Kopfzeile, die das Projekt nennt, von dem sie abgeleitet sind (Pindrop und FreeFlow, beide MIT). Ein Referenzprojekt ohne Lizenz diente nur als Vorbild für das Verhalten, und meine Hinweise führen keinen Code daraus auf.
Das Sprachmodell habe ich per Benchmark gewählt. Vier Modelle, 23 Testfälle in drei Sprachen, 20 davon für den Aufräum-Schritt. Qwen3.5-4B löste 19 dieser 20 richtig. Ein Konkurrent mit 16 Treffern schlug zwei gefährliche Änderungen vor: Er strich das „nicht“ aus „nicht an meine private Adresse“ und tauschte 450 gegen 540. Die Regeln, die gleich folgen, lehnten beides ab, dafür sind sie da.
Das Modell hat nie freie Hand. Auf der Aufräum-Stufe darf es nur eine Liste von Streichungen liefern, in einem Format, das eine Grammatik erzwingt, und eine Regel lehnt jede Änderung ab, die Wörter hinzufügt, umstellt oder entfernt, die ich nicht markiert habe. Auf der Umformulier-Stufe, die mit dem aufgeräumten Text arbeitet, prüft ein deterministischer Wächter Zahlen, eine verlorene Verneinung, E-Mail-Adressen und Links, die Anrede (du oder Sie) und die Sprache. Besteht eine Prüfung nicht, wird stattdessen die vorherige Fassung eingefügt. Namen prüft der Wächter nicht, und der Hilfetext der App sagt das jetzt auch.
Ich habe mit gesprochener Sprache getestet. Gesprochenes Audio brachte Fehler ans Licht, die getippter Testtext nicht gezeigt hatte: Die Spracherkennung lässt die Kommas um eine gesprochene Korrektur weg, schreibt Zahlen als Wörter, und das Modell machte einmal aus „quinientos cuarenta“ die Zahl 450. Vier Fehlerklassen, alle inzwischen behoben.
Text in eine andere App zu bringen ist eine Leiter aus Prüfungen. Die App merkt sich das Feld, in das Sie diktiert haben, stellt sicher, dass Sie weder die App gewechselt haben noch in einem Passwortfeld gelandet sind, fügt ein und liest das Feld zurück, um zu sehen, ob der Text angekommen ist. Wenn sie das nicht beurteilen kann, sagt sie es. Ich habe eine Messfunktion in die App gebaut, statt zu raten, welche Apps was zulassen.
Lernen aus Korrekturen nur mit Ihrer Zustimmung. Korrigieren Sie ein Wort direkt nach dem Diktat, bietet die App an, es ins Wörterbuch aufzunehmen. Von allein nimmt sie nie etwas auf.
Drei Sprachen vom ersten Tag an. 213 Oberflächentexte pro Sprache, mit einer Build-Prüfung auf fehlende Texte und auf den Ton.
Am Ende habe ich bewusst weniger gemacht. Signiert für meine eigenen Macs, keine Notarisierung, keine automatischen Updates. Ein Werkzeug für eine Person braucht keine Vertriebsmaschine.
Was schiefgelaufen ist
Die Oberflächentexte behaupteten, die KI schütze Namen. Der Wächter tut das nicht. Ich habe es beim Gegenlesen jedes Textes gegen den Code gemerkt und den Text korrigiert. Die erste Formulierung der Stilzeilen pro App ließ Inhalt weg: In drei der Stile verschwand „no la pequeña“ (nicht die kleine) aus einem spanischen Satz. Ich habe gemessen, die Anweisung umgeschrieben und erneut gemessen. Text, der nach einem fehlgeschlagenen Einfügen in der Zwischenablage blieb, etwa aus einem Passwortfeld, war nicht als flüchtig markiert, sodass Zwischenablage-Manager ihn aufzeichnen konnten. Das fiel beim Dokumentieren des Projekts auf und hat jetzt einen Test.
Der Name
Es begann als Zefiro, ein Arbeitsname. Eine Vorprüfung fand eine App dieses Namens im App Store und keine freien Domains, also habe ich einen neuen gesucht: rund 300 Kandidaten in drei Runden. Die meisten wurden von neun synthetischen Stimmen auf Deutsch, Spanisch und Englisch gesprochen, und die engere Auswahl habe ich auf Bedeutung, Kollisionen und Gegengründe geprüft. Der Test zeigte, dass erfundene, weich klingende Namen jedes Mal anders geschrieben zurückkommen. Ich habe trotzdem Flabbeo gewählt, gegen das Ergebnis, weil das Werkzeug für mich ist. In meiner eigenen Stimme schrieb die App den Namen in 5 von 18 Versuchen richtig, alle fünf auf Deutsch; auf Spanisch schreibt sie „flaveo“. Dafür ist das lernende Wörterbuch da. Der Name hat keine Markenprüfung durchlaufen.
Was es noch nicht kann
Es wurde auf einem Mac getestet. Auf meinem. Die Installation auf einem zweiten steht noch aus.
Es kann in drei von acht Apps bestätigen, dass der Text angekommen ist. In den anderen fünf kann es das Feld nicht lesen und sagt es Ihnen, statt doppelt einzufügen.
Manche Teile haben keine automatischen Tests. 347 Tests in 54 Suiten decken die Logik drumherum ab. Die Spracherkennung selbst und die Fenster der App prüfe ich von Hand, und nichts führt die Tests bei jeder Änderung automatisch aus.
Es gibt keine Genauigkeitszahl für die Spracherkennung. Nur Stichproben mit synthetischen Stimmen und meine eigene Nutzung.
Der Stil pro App zeigt sich bei kurzen Diktaten kaum. Ein Test mit langen Diktaten fehlt noch.
Rund 13.900 Zeilen Swift in 13 Modulen. Es bleibt auf meinem Mac und ist nicht zu verkaufen.
Jede Entscheidung hier hat einen Grund, die meisten haben eine Messung oder einen Test. Wo nicht, sagt die Seite es.
Haben Sie ein ähnliches Projekt?
Erzählen Sie mir, was Sie vorhaben. Ich sage Ihnen ehrlich, ob ich helfen kann, und was es dafür braucht.
Erzählen Sie mir von Ihrem Projekt →Sie haben direkt mit mir zu tun, vom ersten Gespräch bis zur finalen Übergabe.